Ein Werksleiter, der ein ML-Projekt abwägt, steht meist zuerst vor einer Frage: Welcher Anwendungsfall rechnet sich innerhalb eines Jahres, und was ist dafür nötig? Die kurze Antwort: Machine Learning in der Fertigung zahlt sich heute an drei Stellen aus, bei vorausschauender Wartung, bei bildbasierter Qualitätsprüfung sowie bei Bedarfs- und Prozessoptimierung. Jeder dieser Fälle besteht aus einer Datenpipeline, einem Modell und einer Integration in das MES, ERP oder CMMS, das im Werk bereits läuft, und jeder hängt von Daten ab, die die meisten Werke nur teilweise haben.
Die meisten Werke besitzen bereits einen Teil dieses Fundaments: Sensoren an kritischen Anlagen, einen Historian und ein ERP mit jahrelanger Auftragshistorie. Über die Amortisation entscheidet, wie gut diese Bausteine verbunden sind und wie ehrlich das erste Projekt daran ausgerichtet wird. Dieser Leitfaden ist aus Sicht der Umsetzung geschrieben, auf Basis von Redwerks Arbeit in der Fertigungs-Software-Entwicklung und bei KI-Projekten, und geht jeden Anwendungsfall mit seinem Stack und seinen Datenvoraussetzungen durch.
Vorausschauende Wartung
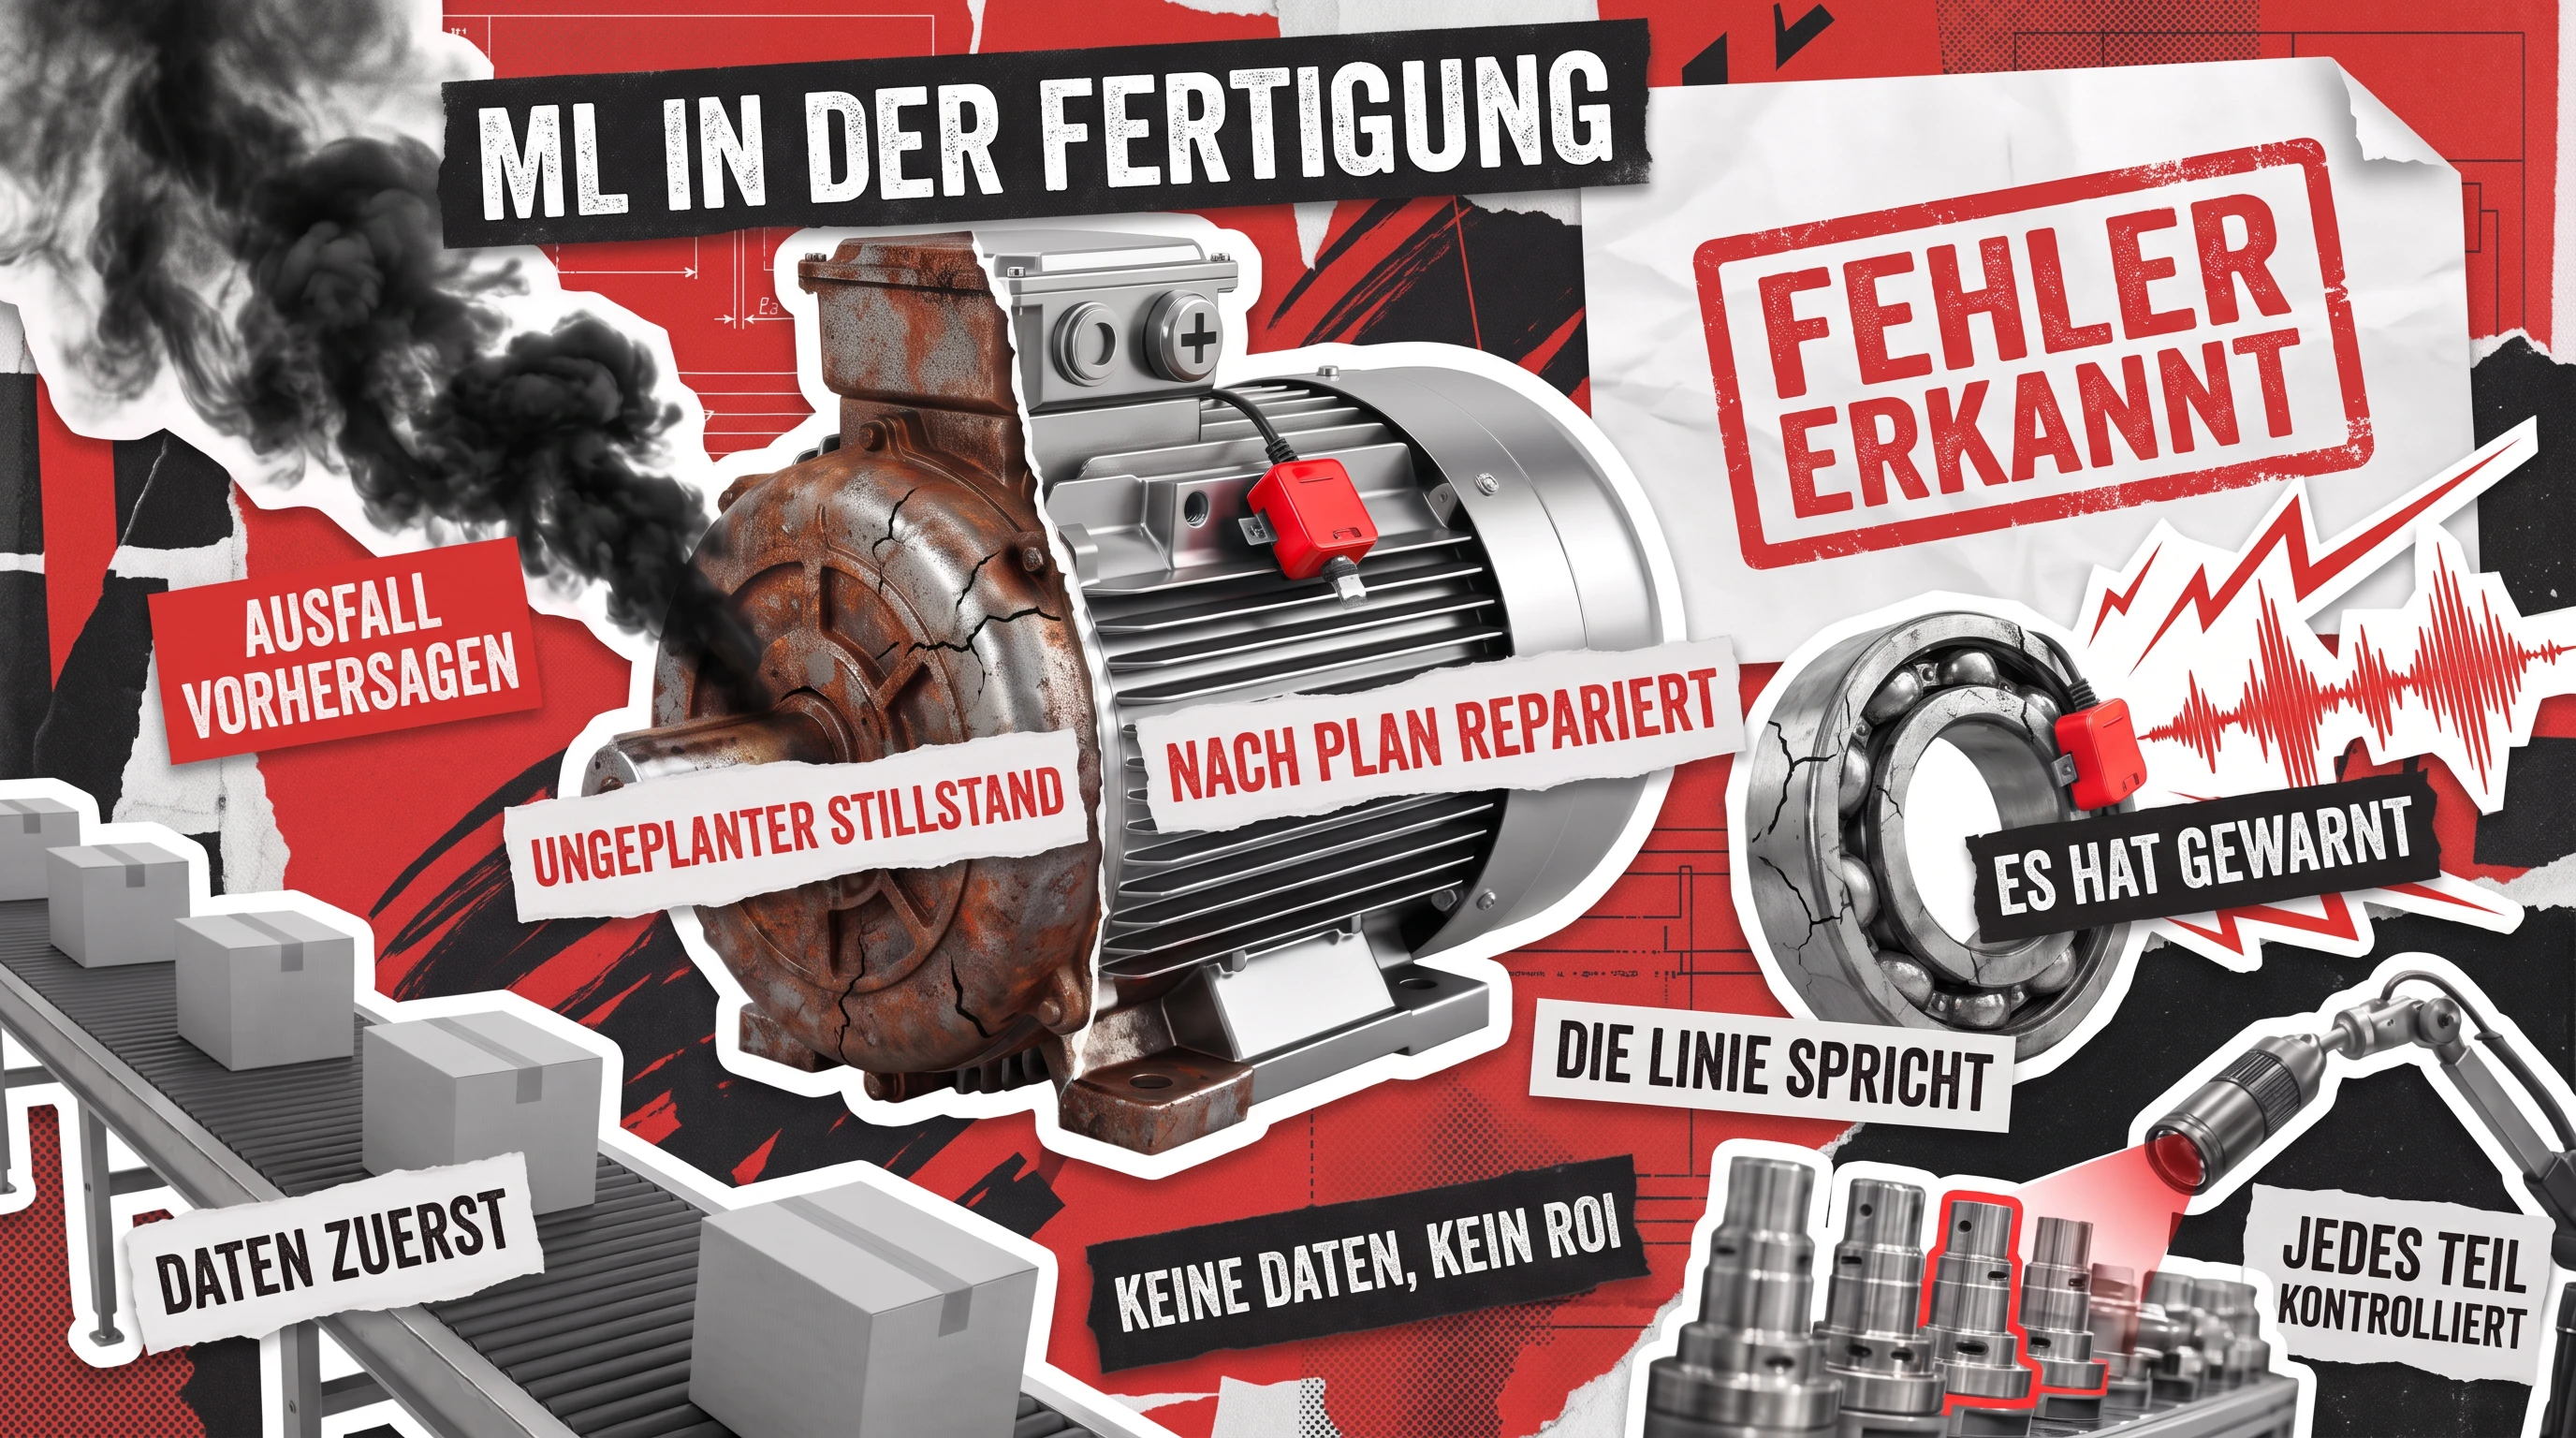
Vorausschauende Wartung mit Machine Learning (Predictive Maintenance) ist der ausgereifteste Anwendungsfall in der Produktion und meist der mit der schnellsten Amortisation. Streaming-Daten von Motoren, Lagern, Pumpen, CNC-Spindeln und HLK-Anlagen speisen eine Anomalieerkennung, die Komponenten markiert, die wahrscheinlich ausfallen werden, bevor es so weit ist. Warnungen landen im CMMS als Arbeitsaufträge mit einem Konfidenzwert und einer empfohlenen Vorlaufzeit, sodass Planer die Reparatur in einen geplanten Stillstand legen können.
Was unter der Haube steckt
Eine typische Pipeline beginnt an der Steuerung. OPC UA-Gateways und MQTT-Broker lesen Messwerte aus SPS und Edge-Sensoren aus, und Apache Kafka überträgt den Datenstrom an einen Feature Store, der gleitende Zeitfenster berechnet, etwa Vibrationswerte der letzten zehn Minuten oder Temperaturdrift über eine Schicht. Darauf setzt eine Kombination von Modellen auf, jedes für eine bestimmte Aufgabe gewählt. Isolation Forest erkennt Ausreißer kostengünstig, noch bevor gelabelte Ausfälle vorliegen, Gradient-Boosted Trees bewerten das Ausfallrisiko, sobald sich gelabelte Historie aufgebaut hat, und LSTM-Autoencoder lernen den normalen Verlauf eines Signals und melden Abweichungen davon.
Das Training findet meist in der Cloud statt, wo Rechenleistung günstig und die gesamte Historie verfügbar ist. Die Inferenz wandert auf ein Edge-Gerät oder läuft direkt auf der Steuerung, wenn das Latenzbudget knapp ist, also bei Anlagen, bei denen eine Warnung innerhalb von Sekunden eintreffen muss.
Wo sich der ROI zuerst zeigt
Erträge zeigen sich zuerst bei hochwertigen rotierenden Anlagen, energieintensiven Linien und jeder Anlage, bei der ein ungeplanter Stillstand bis in die nächste Schicht durchschlägt. Bei diesen Anlagen bewegen sich Ausfallzeiten und mittlere Betriebsdauer zwischen Ausfällen (MTBF) typischerweise innerhalb von 1 bis 2 Quartalen nach dem Go-live, weil jeder vermiedene Ausfall an einer kritischen Anlage teuer ist. An der Spitze sind die Zahlen groß: Im Werk Hawiyah NGL von Saudi Aramco steigerten KI-gestütztes Asset Management und digitale Zwillinge die Gesamtanlageneffektivität (OEE) um 44 %, laut dem Lighthouse-Update des Weltwirtschaftsforums vom Juni 2026. Es handelt sich um selbst berichtete Ergebnisse von Vorzeigestandorten. Betrachten Sie sie daher als Obergrenze und legen Sie Ihre eigene Ausgangsbasis anhand aktueller MTBF-Werte und Stillstandsprotokolle fest.
Qualitätskontrolle und Fehlererkennung
Für die Qualitätskontrolle mit Machine Learning setzen Produktionslinien auf Computer Vision, die jede Einheit auf Oberflächenfehler, Maßabweichungen, Montagefehler sowie Etiketten- oder Verpackungsmängel prüft. Das Modell ordnet eine Fehlerklasse zu, protokolliert das Bild und schleust die Einheit entweder aus der Linie aus oder leitet sie zur schnellen Freigabe an einen Prüfer weiter. Die manuelle Prüfung erfasst nur eine Stichprobe der Produktion und lässt im Laufe einer Schicht nach, während eine Kamera jede Einheit in Liniengeschwindigkeit prüft, um 3 Uhr morgens mit demselben Schwellenwert wie um 9 Uhr. Bilderkennung und Objekterkennung sind zentrale Bestandteile von Redwerks Arbeit in der KI-basierten Softwareentwicklung. Daher ist dies der Anwendungsfall, bei dem unsere Kompetenz am direktesten in die Produktion übertragbar ist.
Die vier Bausteine eines visuellen Prüfsystems
- Kamera und Beleuchtung. Ausgelegt auf die kleinste Fehlerklasse, die erkannt werden muss. Gleichmäßige Beleuchtung ist ebenso wichtig wie die Auflösung, denn eine Reflexion, die das Modell nie gesehen hat, kann als Fehler erkannt werden.
- Gelabelter Fehlerdatensatz. Der Teil, den die meisten Projekte unterschätzen. Mehr dazu im Abschnitt zur Datenreife weiter unten.
- Modell. Ein Convolutional Neural Network oder Vision Transformer, der auf diesem Datensatz trainiert wird, typischerweise in PyTorch, und anschließend für schnelle Inferenz exportiert wird.
- Edge-Inferenz und Integration. Das Modell läuft auf einem Industrie-PC oder einer Edge-Box direkt an der Linie, und die Ergebnisse fließen ins QMS und MES, sodass jede ausgeschleuste Einheit ihr Bild, ihre Fehlerklasse und ihren Zeitstempel mitführt.
Wo sich visuelle Qualitätskontrolle zuerst auszahlt
Wirtschaftlich rechnet es sich am schnellsten dort, wo ein menschlicher Prüfer derzeit der Engpass ist oder wo ein Fehler, der zum Kunden durchrutscht, Rückrufe, Retouren oder einen verlorenen Auftrag nach sich zieht. Das betrifft die Elektronikmontage mit hoher Variantenvielfalt, Verpackung in der Lebensmittel- und Getränkeindustrie sowie die pharmazeutische Abfüllung (Fill-and-Finish). Standorte, die vom Weltwirtschaftsforum im Januar 2026 ausgezeichnet wurden, zeigen das Potenzial: Haier Strauss in Qingdao senkte die Fehlerquote um 40 % und die Qualitätskosten um 72 %, und EVE Energy in Jingmen reduzierte seine Fehlerquote um 52 %, indem es Echtzeit-Qualitätsdiagnose mit vorausschauender Wartung kombinierte. Die Genauigkeit gilt für die Fehlerklassen, auf die ein Modell trainiert wurde. Eine neue Produktvariante oder geänderte Verpackung erfordert daher neue gelabelte Bilder, bevor das Modell diese Prüfung übernimmt.
Produktionsoptimierung und Lieferkette
In der Planung ersetzt ML statische Regeln durch Prognosen, die sich bei veränderten Bedingungen aktualisieren, aufgebaut auf denselben vernetzten Daten, die auch die digitale Transformation in der Fertigung antreiben. Modelle für die Bedarfsprognose lernen aus historischen Aufträgen, Saisonalität und Echtzeitsignalen, und ihre Ergebnisse fließen in den Produktionsplan ein. Modelle zur Prozessoptimierung stimmen Liniengeschwindigkeiten, Ofentemperaturen, Mischrezepturen und Rüstreihenfolgen auf Ausbeute und Energieverbrauch ab. Auf der Beschaffungsseite erkennt ML frühzeitig, wenn sich Lieferzeiten von Lieferanten verschieben, und legt Bestellpunkte auf Basis einer probabilistischen Betrachtung des Fehlmengenrisikos fest. Das passt sich weit besser an als ein Sicherheitsbestand, der einmal im Jahr festgelegt wird.
Wie die Modelle an ERP und MES angebunden werden
Gradient-Boosted Decision Trees, oft mit XGBoost erstellt, sind das Arbeitspferd für Bedarfsprognosen auf tabellarischen Auftragsdaten. Für die Prozessabstimmung kommen Bayes’sche Optimierung oder Reinforcement-Learning-Schleifen zum Einsatz, die einen Sollwert vorschlagen, das Ergebnis beobachten und nachjustieren. Beide brauchen eine bidirektionale Integration: Lesezugriff auf ERP und MES (Auftragsbestand, laufende Fertigung, Lagerbestand) und Rückschreiben in diese Systeme (Produktionsplan, Bestellpunkte). Eine Prognose, die direkt in den Produktionsplan geschrieben wird, verändert, was die Linie morgen fertigt, und genau dort entsteht der Wert.
Wo es zuerst greift
Zwei Werksprofile sehen zuerst Ergebnisse. Montagewerke mit mittleren Stückzahlen, einem funktionierenden ERP und stabilen Stammdaten können innerhalb von 1 bis 2 Quartalen von Tabellenkalkulations-Prognosen auf ML-Prognosen umsteigen. Werke mit kontinuierlichen Prozessen profitieren am meisten von der Prozessabstimmung, wo 1 % mehr Ausbeute oder weniger Energieverbrauch ein spürbarer Posten ist, weil sich dieser Gewinn über jede Betriebsstunde summiert. In beiden Profilen entsteht der erste Erfolg meist aus einem eng gefassten Umfang, etwa einer Produktfamilie für die Prognose oder einer Linie für die Sollwertabstimmung, gemessen an dem Plan, den die Planer ohne das Modell erstellt hätten.

Der Einstieg: Datenreife für Machine Learning in der Fertigung
Bevor einer der oben genannten Anwendungsfälle konkret geplant wird, stellt ein Werksbetreiber eine Frage: Wie müssen unsere Daten aussehen, damit sich ein ML-Projekt rechnet? Hier werden die meisten Projekte gewonnen oder verloren, und hier verdienen Dienstleistungen zur Entwicklung künstlicher Intelligenz ihr Honorar, lange bevor ein Modell trainiert wird. Eine systematische Übersichtsarbeit aus dem Jahr 2026 zu 89 Studien über vorausschauende Wartung in der Fachzeitschrift Information ergab, dass 65,6 % eine schwache oder unklare Validierung verwendeten und keine eine operative Validierung im Feld erreichte. Der Abstand zwischen einer vielversprechenden Veröffentlichung und einem funktionierenden System im Werk besteht vor allem aus Daten und Integration. Deshalb prüfen wir zuerst drei Dinge.
Vorausschauende Wartung
1 bis 2 Quartale
Sensortelemetrie, Historian mit 6 bis 12 Monaten Ausfallereignissen
Hochwertige rotierende Anlagen, energieintensive Linien
Bildbasierte Qualitätskontrolle
2 bis 3 Quartale
Gelabelter Fehlerbilddatensatz, kontrollierte Beleuchtung
Elektronik mit hoher Variantenvielfalt, Verpackung, Pharma-Abfüllung
Bedarfsprognose
1 bis 2 Quartale
Saubere Auftrags- und Versandhistorie im ERP, gepflegte Stammdaten
Montage mit mittleren Stückzahlen, saisonale Artikel
Prozessoptimierung
2 bis 4 Quartale
Echtzeit-Prozessdaten, Ausbeute- und Energielabels
Werke mit kontinuierlichen Prozessen
Generatives Design
Mehrjähriges Programm
CAD-, Simulations- und Materialbibliotheken
F&E-Abteilungen auf OEM-Niveau
Sensorabdeckung und Telemetriequalität
ML in der Produktion steht und fällt mit den Sensordaten. Bevor Sie ein Projekt zur vorausschauenden Wartung planen, müssen Sie wissen, welche Anlagen bereits instrumentiert sind, mit welcher Abtastrate und ob der Historian genug Historie für das Training speichert, typischerweise sechs bis zwölf Monate einschließlich gelabelter Ausfallereignisse. Wo die Abdeckung dünn ist, besteht Phase eins des Projekts aus der Instrumentierung, und die Modellierung beginnt, sobald die ersten Monate sauberer Daten vorliegen.
Gelabelte Daten für Vision-Modelle
Ein Modell zur Fehlererkennung ist nur so gut wie der gelabelte Datensatz dahinter. Das bedeutet meist einige tausend Bilder pro Fehlerklasse, aufgenommen unter der tatsächlichen Beleuchtung und Kamerageometrie der Linie und geprüft von einem QC-Verantwortlichen. Wer diesen Aufwand von Anfang an benennt, vermeidet das Ergebnis „Wir haben ML ausprobiert, und es hat nicht funktioniert“ nach sechs Monaten.
Integration von MES, ERP und CMMS
Das Modell ist selten der Teil, der auf der grünen Wiese entsteht. Die Linie läuft bereits mit einem MES, das ERP hält den Auftragsbestand, das CMMS die Wartungshistorie, und ein Historian speichert oft die Zeitreihen. Der größte Teil der Entwicklungsarbeit fließt in die Integrationsschicht: Lesezugriffe auf diese Systeme, Rückschreiben in sie, berechtigungsgesteuerte Schnittstellen, Audit-Trails und ein Eskalationspfad mit menschlicher Prüfung (Human-in-the-Loop) für jede Vorhersage unterhalb des Konfidenzschwellenwerts.
Redwerks ML-Erfahrung im großen Maßstab stammt aus einer benachbarten Branche: Für eine Recruiting-Plattform haben wir in Azure Machine Learning Studio ein neuronales Netz trainiert, das 1,5 Millionen Texte verarbeitete, um relevante Schlüsselwörter vorzuschlagen. Dieselbe Disziplin lässt sich auf ein Werk übertragen: Daten bereinigen, mit den Systemen integrieren, die die Mitarbeitenden bereits nutzen, und den Menschen in der Entscheidungsschleife halten. Das heißt auch, dass Sie ohne vollständige Spezifikation starten können, denn das Datenaudit selbst definiert den Umfang des ersten Projekts.
Ein fokussierter Weg zum ROI mit ML in der Fertigung
Die Systeme, die 2026 vom Pilotprojekt in die Produktion übergehen, sind vorausschauende Wartung, bildbasierte Qualitätskontrolle sowie Bedarfs- und Prozessoptimierung. Generatives Design und vollständig menschenleere Fabriken (Lights-out) bleiben ein längerfristiger Horizont, beobachtenswert, aber selten die richtige erste Investition für ein mittelgroßes Werk. Alle drei kurzfristigen Systeme folgen einem gemeinsamen Muster: einer Datenpipeline, einer Modellschicht und der Integration in das MES, ERP, CMMS oder QMS, das im Werk bereits läuft. Die Werke, die Erträge sehen, wählen eine hochwertige Anlage oder Linie, belegen die Zahlen dort und bauen von einer funktionierenden Basis aus. Wenn Sie ML auch über die Produktion hinaus abwägen, vergleicht unser Leitfaden zu Machine Learning Anwendungsfällen für Unternehmen die Optionen branchenübergreifend.
Redwerk bringt Computer Vision, Predictive Analytics und ML-Umsetzung im großen Maßstab in dieses erste Projekt ein, mit einem Team, das mit einem Datenaudit statt einer fertigen Spezifikation beginnen kann. Wenn Sie eine Anlage haben, die immer wieder stillsteht, oder eine Linie, bei der die Prüfung der Engpass ist, sprechen Sie mit uns über Ihr Fertigungsprojekt: Kontaktieren Sie uns, und wir helfen Ihnen, einen ersten Schritt rund um die Daten zu planen, die Sie bereits haben.
FAQ
Wie wird Machine Learning heute in der Fertigung eingesetzt?
Hersteller setzen ML auf vier Hauptwegen ein. Vorausschauende Wartung erkennt auf Basis von Sensordaten Anlagen, die wahrscheinlich ausfallen. Bildbasierte Qualitätskontrolle prüft jede Einheit in Liniengeschwindigkeit auf Fehler. Bedarfsprognosen fließen in Produktionspläne und Bestellpunkte ein. Prozessoptimierung stimmt Sollwerte wie Liniengeschwindigkeit und Temperatur auf Ausbeute und Energieverbrauch ab.
Was ist vorausschauende Wartung mit Machine Learning?
Es ist der Einsatz von ML-Modellen auf Streaming-Sensordaten wie Vibration, Temperatur und Motorstrom, um vorherzusagen, welche Komponenten wann ausfallen. Das Modell erzeugt im CMMS einen Arbeitsauftrag mit Konfidenzwert und empfohlener Vorlaufzeit, sodass Reparaturen während geplanter Stillstände erfolgen statt nach einem Ausfall.
Wie verbessert ML die Qualitätskontrolle an einer Produktionslinie?
Kameras und ein trainiertes Vision-Modell prüfen jede Einheit statt einer Stichprobe, klassifizieren Fehler wie Kratzer, Fehlausrichtung oder Etikettenmängel und protokollieren jedes Bild. Die Ergebnisse fließen für vollständige Rückverfolgbarkeit ins QMS und MES. Die Genauigkeit ist bei den Fehlerklassen hoch, auf die das Modell trainiert wurde, und neue Varianten benötigen neue gelabelte Bilder.
Welche Daten braucht ein Hersteller, bevor er ein ML-Projekt startet?
Drei Dinge. Für vorausschauende Wartung Sensortelemetrie mit ausreichender Historie, meist sechs bis zwölf Monate einschließlich gelabelter Ausfallereignisse. Für Vision-Anwendungen einen gelabelten Bilddatensatz, der unter realen Linienbedingungen aufgenommen wurde. Zugriff auf MES, ERP und CMMS, denn Vorhersagen schaffen erst dann Wert, wenn sie in die Systeme zurückgeschrieben werden, die das Werk nutzt.
Lohnt sich ML für mittelgroße Fertigungsbetriebe?
Ja, wenn das erste Projekt zu den Daten passt, die das Werk bereits hat. Vorausschauende Wartung an kritischen rotierenden Anlagen und visuelle Prüfung an einer Engpasslinie sind die stärksten Optionen, mit Ergebnissen, die oft innerhalb weniger Quartale sichtbar werden. Generatives Design und werksweite Autonomie sind längere Programme, die eher zu F&E-Budgets und Zeitplänen auf OEM-Niveau passen.
Erfahren Sie, wie Redwerk ein neuronales Netz mit über 1,5 Millionen Datensätzen trainierte, um eine KI-Matching-Plattform zu betreiben, die später von einem US-Personalvermittlungsriesen übernommen wurde