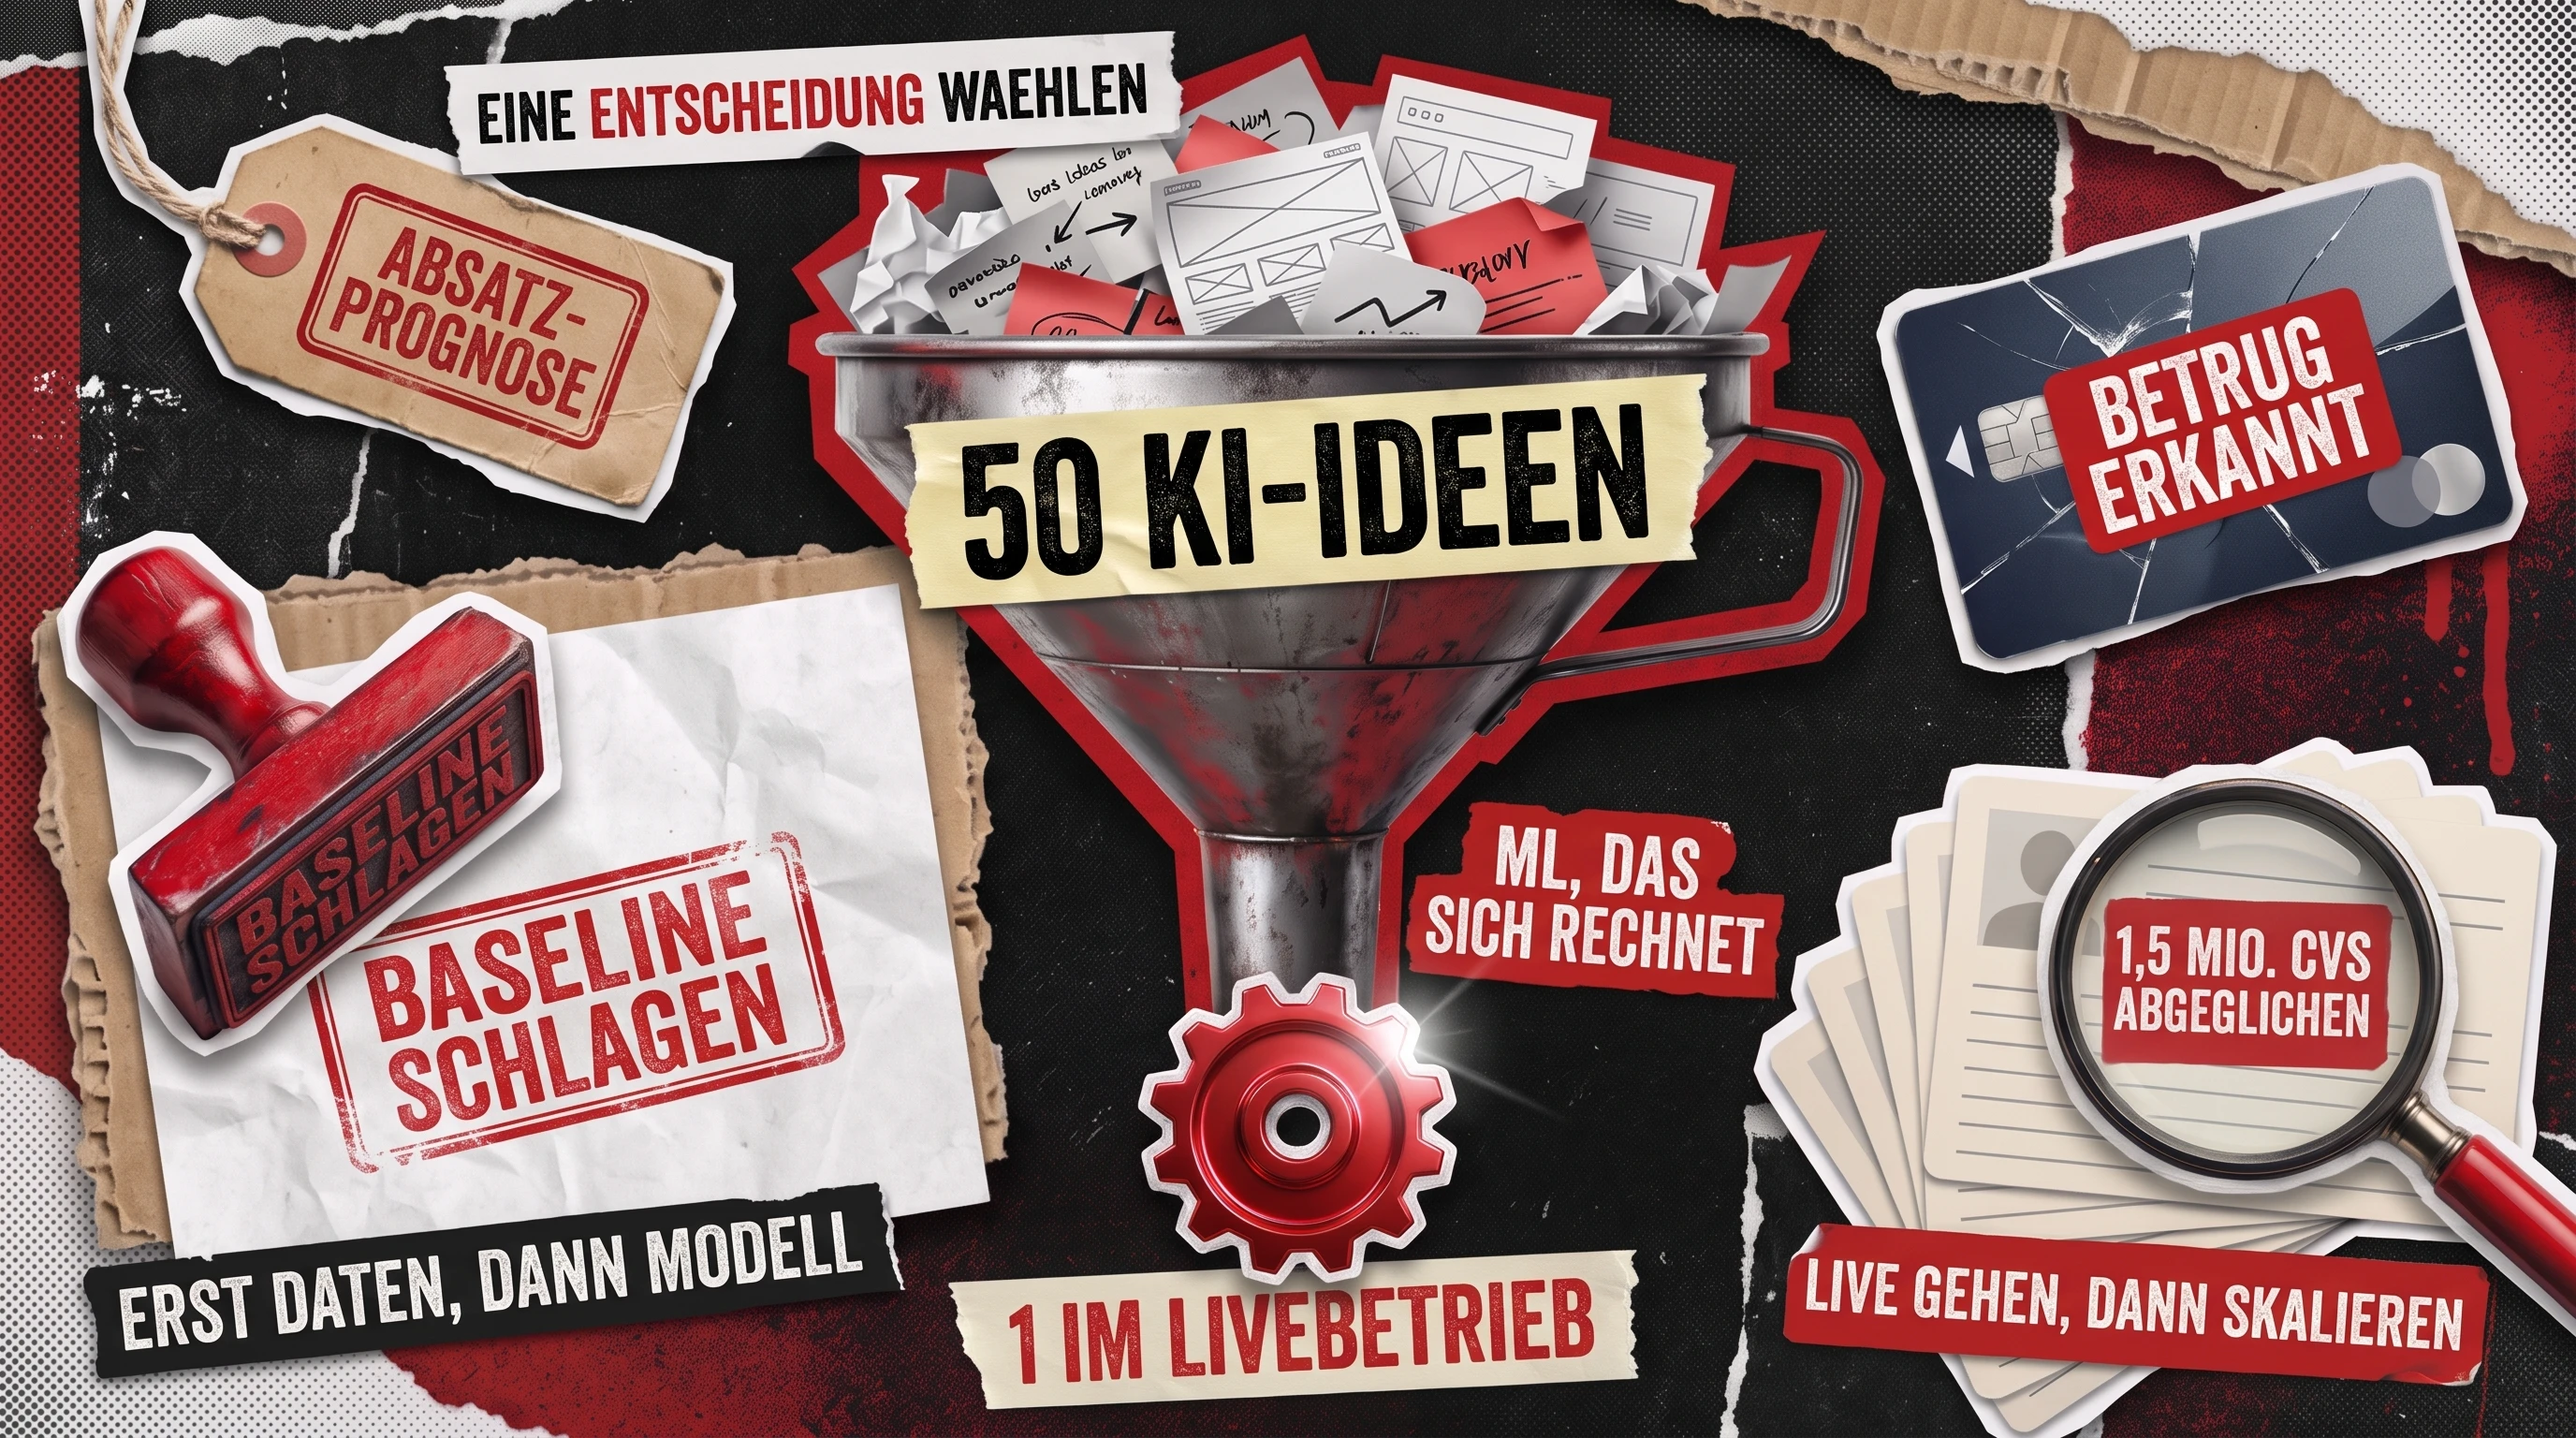
Machine Learning Anwendungsfälle, die 2026 eine Investition wert sind, haben drei Merkmale gemeinsam: eine Entscheidung, die Ihr Team immer wieder trifft, historische Daten, die festhalten, wie diese Entscheidung ausgegangen ist, und eine Baseline, die das Modell schlagen muss. Nachfrageprognose, Churn-Prognose, Betrugs-Scoring, Datenextraktion aus Dokumenten und Kandidaten-Matching erfüllen alle drei Kriterien. Deshalb dominieren sie die produktiven Einsätze in mittelständischen Unternehmen.
Die meisten Übersichten listen fünfzig Ideen auf und belassen es dabei. Dieser Leitfaden behandelt, was ein mittelständisches Unternehmen in diesem Jahr realistisch umsetzen kann, gruppiert nach Unternehmensfunktion und zugeordnet zu den Branchen, in denen sich der jeweilige Anwendungsfall bewährt hat. Die Beispiele stammen aus unseren eigenen Projekten, darunter eine Recruiting-Plattform, für die unsere Entwickler ein CV-Matching-Modell mit mehr als 1,5 Millionen Texten trainiert haben. Wenn Sie abwägen, ob Sie intern einstellen oder auf Dienstleistungen für KI-Entwicklung setzen, finden Sie im letzten Abschnitt einen Filter in fünf Schritten für die Wahl des ersten Projekts.
Anwendungsfälle für Predictive Analytics
Predictive Analytics ist der Bereich, in dem die meisten Unternehmen den ersten Ertrag aus Machine Learning sehen, denn die Trainingsdaten liegen bereits in ERP, CRM oder Abrechnungssystem. Historische Datensätze mit bekanntem Ergebnis bringen einem Modell bei, neue Datensätze zu bewerten, bevor dieses Ergebnis eintritt. Das Modell ersetzt selten einen Menschen. Es sortiert eine Warteschlange neu, markiert eine Ausnahme oder grenzt eine Liste ein, sodass das Team seine Zeit in die Fälle investiert, auf die es ankommt.
Nachfrageprognose im Einzelhandel und E-Commerce
Die Nachfrageprognose sagt voraus, wie viele Einheiten jeder SKU pro Filiale, Kanal und Woche verkauft werden, basierend auf Verkaufshistorie, Preisen, Aktionen, Saisonalität und Fehlbeständen. Gradient-Boosting-Modelle wie LightGBM kommen mit diesen tabellarischen Daten gut zurecht und lassen sich in wenigen Minuten neu trainieren.
Die eigentliche Schwierigkeit liegt in den Daten rund um die Verkaufszahlen. Eine nicht erfasste Aktion wirkt wie ein zufälliger Ausreißer, und ein Fehlbestand wirkt wie sinkende Nachfrage. Beides bringt dem Modell das Falsche bei. Neue Produkte brauchen einen Cold-Start-Ansatz, der Muster von ähnlichen Artikeln übernimmt.
Churn-Prognose für SaaS- und Abo-Unternehmen
Ein Churn-Modell bewertet jeden Kunden nach seinem Risiko, in den nächsten 30 bis 90 Tagen zu kündigen oder herabzustufen. Die aussagekräftigsten Signale betreffen das Nutzungsverhalten:
- Rückläufige Logins oder aktive Lizenzen im Verhältnis zum gebuchten Tarif
- Geringere Nutzung der Funktionen, die mit dem Kern-Workflow des Kunden verknüpft sind
- Wiederholte Support-Tickets zum selben Problem
- Fehlgeschlagene Zahlungen und Abrechnungsstreitigkeiten
- Der ursprüngliche Fürsprecher verlässt das Unternehmen des Kunden
Definieren Sie “Churn” vor Beginn des Trainings, denn eine Nichtverlängerung, ein Downgrade und ein pausiertes Konto brauchen unterschiedliche Labels. Eine wöchentliche Liste an das Customer-Success-Team, mit den wichtigsten Gründen pro Kunde, macht aus dem Score einen Anruf zur Kundenbindung.
Kreditscoring und Betrugserkennung im Fintech-Bereich
Die Betrugserkennung muss einen winzigen Anteil betrügerischer Transaktionen in den Millisekunden zwischen Kartenzahlung und Freigabe erkennen. Die meisten Teams betreiben das Modell parallel zu ihrer bestehenden Regel-Engine und übertragen ihm schrittweise Entscheidungen, sobald es sowohl Betrugsverluste als auch Fehlablehnungen senkt, denn jede Fehlablehnung ist ein echter Kunde, der an der Kasse blockiert wird.
Beim Kreditscoring kommt eine rechtliche Ebene hinzu. Kreditgeber in den USA müssen Antragstellern die konkreten Gründe für eine Ablehnung nennen. Das drängt Teams zu interpretierbaren Modellen oder zu Erklärungswerkzeugen, die auf komplexen Modellen aufsetzen. Grenzfälle landen in einer Prüfwarteschlange für Underwriter.
Predictive Maintenance: Ein kurzer Hinweis für Industrieunternehmen
Predictive Maintenance prognostiziert Geräteausfälle anhand von Vibrations-, Temperatur-, Druck- und Laufzeitdaten. Dafür braucht es Sensordaten über Monate sowie ein Protokoll tatsächlicher Ausfälle. Viele Werke haben zwar die Sensoren, aber kaum gelabelte Ausfälle, weil gute Instandhaltungsteams Maschinen reparieren, bevor sie kaputtgehen. Beginnen Sie in diesem Fall mit einer Anomalieerkennung, die ungewöhnliche Messwerte für einen Techniker markiert, und sammeln Sie dabei nach und nach Ausfall-Labels.
Anwendungsfälle für Computer Vision und NLP
Bei unstrukturierten Daten (PDFs, gescannte Formulare, Produktfotos, E-Mails und Chatprotokolle) haben sich ML-Anwendungsfälle für Unternehmen in den letzten zwei Jahren am schnellsten ausgeweitet. Mit vortrainierten Vision- und Sprachmodellen kann ein Projekt mit einem deutlich kleineren gelabelten Datensatz starten als noch vor wenigen Jahren. Der Haken sind die Kosten: Ein großes gehostetes Modell eignet sich für schnelle Prototypen, wird bei hohem Volumen aber teuer, während ein kleineres feinabgestimmtes Modell pro Anfrage weniger kostet.
Dokumentenverarbeitung für Finanzwesen, Recht und Versicherungen
Rechnungen, Verträge, Schadensformulare und Onboarding-Dokumente durchlaufen dieselbe Pipeline. OCR wandelt den Scan in Text um, ein Layout-Modell findet die Felder, ein Extraktionsmodell liest sie aus, Geschäftsregeln validieren die Werte, und alles unterhalb eines Konfidenzschwellenwerts geht an einen Menschen. Dieser Schwellenwert entscheidet, wie viele Dokumente ohne manuelle Prüfung durchlaufen.
Klassische Modelle haben hier nach wie vor ihre Berechtigung. Unser Team hat in Azure Machine Learning eine Pipeline zur Textklassifizierung mit logistischer Regression auf TF-IDF- und N-Gramm-Features gebaut, mit 160.000 Datensätzen trainiert und als Webservice bereitgestellt. Dieses Modell ist schnell, günstig und leicht erklärbar, während große Sprachmodelle sich für unübersichtliche Extraktionsaufgaben eignen, etwa für Verlängerungsklauseln, die tief in Verträgen versteckt sind.
Visuelle Suche und Produkt-Tagging im Einzelhandel
Computer Vision zahlt sich im Einzelhandel dort aus, wo die Katalogpflege manuell und repetitiv ist:
- Attribut-Tagging. Ein Modell liest Produktfotos aus und ergänzt Farbe, Muster, Material und Schnitt für schnelleres Listing und einheitliche Filter.
- Visuelle Ähnlichkeitssuche. Kunden laden ein Foto hoch oder klicken auf “Mehr davon” und erhalten passende Artikel.
- Content-Moderation. Uploads von Nutzern werden geprüft, bevor sie online gehen. Auf einer von uns umgesetzten Recruiting-Plattform prüfte der Content-Moderation-Dienst von Azure Texte, Bilder und Videos und leitete markierte Inhalte an einen Freigabe-Workflow weiter.
Bibliotheken wie OpenCV übernehmen die Vorverarbeitung, und die Erkennung läuft auf einem vortrainierten Modell, das auf den Katalog des Händlers feinabgestimmt ist. Dieses Fine-Tuning ist wichtig, denn Studioaufnahmen, Lieferantenbilder und Kunden-Uploads sehen für ein Modell sehr unterschiedlich aus.
Chatbots und virtuelle Assistenten mit Eskalationslogik
Der Stanford AI Index 2026 fasst Studien zusammen, die Produktivitätssteigerungen von 14 % bis 15 % im Kundensupport zeigen. Diese Zuwächse stammen von Assistenten, die Routinefragen beantworten und alles andere mit vollständigem Kontext an einen Menschen übergeben.
Eskalationsauslöser entscheiden darüber, ob Kunden den Assistenten lieben oder hassen. Gute Auslöser sind eine niedrige Modellkonfidenz, negative Stimmung, dieselbe Frage zum zweiten Mal, hochwertige Kunden und regulierte Themen wie Abrechnungsstreitigkeiten. Bei der Übergabe sieht der Mitarbeiter das Gesprächsprotokoll und die Kontodaten.
Recruiting und Talent-Matching im großen Maßstab
Im Recruiting verfügt unser Team über die umfangreichste praktische ML-Erfahrung. Für eine Recruiting-SaaS auf Basis von .NET und Azure haben wir mit Azure ML Studio ein neuronales Netz mit mehr als 1,5 Millionen Lebensläufen und Stellenbeschreibungen trainiert. Das Modell schlägt für jedes Profil und jede Stellenanzeige die relevantesten Keywords vor und treibt die Suche der Plattform an. Die Plattform, Recruit Media, wurde später von HireQuest übernommen.
Modelle für die Personalauswahl tragen besondere Verantwortung. Der EU AI Act stuft KI für Recruiting und Bewerberbewertung als hochriskant ein, mit Anforderungen an Dokumentation, menschliche Aufsicht und Bias-Tests. Protokollieren Sie deshalb, welche Merkmale jedes Matching bestimmt haben, und lassen Sie jede Shortlist von einem Recruiter prüfen.
Machine Learning Anwendungsfälle nach Branche
Die Verbreitung ist je nach Branche ungleich, und das Gefälle zeigt, wo die Vorgehensweisen am ausgereiftesten sind. Laut dem US Census Bureau nutzten im Mai 2026 39,7 % der Unternehmen im Informationssektor und 33,9 % im Finanz- und Versicherungswesen KI, gegenüber rund 14 % im Einzelhandel. Wer Machine Learning Anwendungsfälle nach Branche betrachtet, kann ein bewährtes Muster aus einer benachbarten Branche übernehmen, so wie das Lead-Scoring aus dem SaaS-Vertrieb den Weg in KI in Immobilien-CRMs gefunden hat. Die folgenden vier Branchen sind die Schwerpunkte unserer Projektarbeit.
Gesundheitswesen
Im Gesundheitswesen zahlt sich ML zuerst im operativen Betrieb aus. Mit der Vorhersage von Terminausfällen können Praxen und Kliniken gezielt die richtigen Slots überbuchen, die Triage von Überweisungen sortiert eingehende Dokumente nach Dringlichkeit, und die Zusammenfassung wandelt klinische Notizen in strukturierte Abrechnungsfelder um. Workflow-Automatisierung im Gesundheitswesen zeigt, wo diese Prozesse heute an ihre Grenzen stoßen.
Klinische Anwendungsfälle sind mit höheren Auflagen verbunden. Ein Modell zur Diagnoseunterstützung kann als Medizinprodukt gelten, und jedes Projekt mit Patientendaten braucht HIPAA-konformes Hosting und anonymisierte Trainingsdaten. Wer beides ab dem ersten Sprint der Softwareentwicklung für Healthcare IT einplant, vermeidet einen kostspieligen Umbau vor dem Launch.
Einzelhandel und E-Commerce
Der Einzelhandel bietet die größte Auswahl an bewährten Anwendungsfällen:
- Empfehlungen und Such-Ranking, trainiert auf Klick-, Warenkorb- und Kaufdaten
- Preisoptimierung unter Berücksichtigung von Nachfrage, Lagerbeständen und Wettbewerbsbewegungen
- Retourenprognose, die Bestellungen mit hoher Rücksendewahrscheinlichkeit markiert
- Bestandsverteilung zwischen Lagern auf Basis regionaler Prognosen
Die geringe Verbreitung im Einzelhandel spiegelt den Aufwand wider, Modelle an Legacy-Systeme für Commerce, Kasse und Lager anzubinden. Diese Integration dauert meist länger als die Modellierung.
HR und Recruiting
Innerhalb der Personalabteilung unterstützt ML Entscheidungen zu Mitarbeiterbindung, Kompetenzen und Personalbedarf. Fluktuationsmodelle markieren Teams, in denen die Engagement-Signale sinken, die Kompetenzanalyse erstellt durchsuchbare Profile aus der Projekthistorie, und die Personalplanung prognostiziert den Einstellungsbedarf. Mitarbeiterdaten sind sensibel. Aggregieren Sie Risiken daher auf Teamebene, bevor Sie individuelle Scores offenlegen, und informieren Sie die Mitarbeitenden darüber, was gemessen wird und warum.
Fertigung
Die visuelle Qualitätsprüfung ist der Vorzeige-Anwendungsfall. Kameras erkennen Oberflächenfehler, Fehlausrichtungen und fehlende Bauteile in Taktgeschwindigkeit und lernen dabei aus Bildern von guten und aussortierten Teilen, während die Ausbeute- und Energieoptimierung auf Daten läuft, die in den Historian-Systemen des Werks bereits gespeichert sind.
Die meisten ML-Projekte in der Fertigung geraten bei der Integration mit SPS, MES und ERP-Systemen ins Stocken. Wer das Modell als eine Komponente der Softwareentwicklung für die Fertigung behandelt, gemeinsam mit Datenpipelines, Bediener-Dashboards und Alarmierung, ebnet dem Pilotprojekt den Weg in das gesamte Werk.

So wählen Sie Ihren ersten Machine Learning Anwendungsfall
Die Wahl des ersten Projekts ist wichtiger als die Wahl des Algorithmus. Laut dem Eurostat-Bericht 2026 nutzten 2025 nur 5,1 % der Unternehmen in der EU Machine Learning für die Datenanalyse, und 70,3 % der Unternehmen, die KI in Betracht gezogen und dann darauf verzichtet hatten, nannten fehlende Fachkompetenz als Hauptgrund. Unternehmen, die geschäftliche Machine-Learning-Anwendungen in die Produktion bringen, fangen klein an, messen gegen eine klare Baseline und bauen auf einem funktionierenden System auf. Diese fünf Schritte sind der Filter, den wir gemeinsam mit Kunden anwenden, bevor ein Modell trainiert wird.
Beginnen Sie mit einer Entscheidung, nicht mit einem Datensatz
Halten Sie schriftlich fest, welche Entscheidung das Modell verändern soll, wer sie heute trifft und wie oft. “Welche Kunden sollte das Customer-Success-Team diese Woche anrufen” ist eine Entscheidung, während “Wir haben fünf Jahre CRM-Daten, was kann ML damit anfangen” meist in einem Dashboard endet, das niemand öffnet. Eine Entscheidung, die hunderte Male im Monat getroffen wird, ist ein starker Kandidat, weil sich kleine Verbesserungen schnell summieren.
Prüfen Sie, ob die Daten in Produktionsform vorliegen
Das Modell braucht zum Zeitpunkt der Vorhersage dieselben Felder in derselben Qualität. Prüfen Sie vier Punkte, bevor Sie sich festlegen:
- Das Ergebnis, das Sie vorhersagen möchten, ist für vergangene Fälle mit Datum erfasst.
- Die Eingabefelder stehen zum Zeitpunkt der Vorhersage zur Verfügung, ohne dass Informationen aus der Zukunft einfließen.
- Daten aus verschiedenen Systemen lassen sich über einen verlässlichen Schlüssel verknüpfen.
- Für jede Quelle gibt es einen Verantwortlichen, der Formatänderungen meldet.
Definieren Sie die Baseline, die Sie schlagen müssen
Jedes ML-Projekt braucht einen Vergleichsmaßstab, in der Regel die bereits bestehende Regel oder den manuellen Prozess. Wenn das Modell diesen nicht mit einem Abstand schlägt, der die Betriebskosten rechtfertigt, gewinnt die einfachere Option.
Nachfrageprognose
Dieselbe Woche im Vorjahr oder ein gleitender Durchschnitt
Prognosefehler (WAPE), Fehlbestände
Churn-Prognose
Eine Regel “kein Login seit 30 Tagen”
Gehaltener Umsatz aus markierten Kunden
Betrugserkennung
Die aktuelle Regel-Engine
Betrugsverluste, Rate der Fehlablehnungen
Datenextraktion aus Dokumenten
Manuelle Dateneingabe
Dokumente pro Stunde, Fehlerquote pro Feld
Support-Assistent
Rein menschliche Warteschlange
Lösung ohne Eskalation, CSAT
Kandidaten-Matching
Keyword-Suche durch Recruiter
Quote von Shortlist zu Interview
Beschränken Sie den Umfang auf ein Team und eine Kennzahl
Ein erstes Projekt, das einem Team gehört, an einer Kennzahl gemessen und innerhalb eines Quartals geliefert wird, hat eine echte Chance, in die Produktion zu gelangen. Unternehmensweite KI-Programme verteilen das Budget oft auf zu viele Pilotprojekte, von denen keines die nötige Integrationsarbeit erhält. Wenn Ihrem Team ML-Ingenieure fehlen, bringt individuelle KI-Softwareentwicklung diese Kompetenzen ohne langen Einstellungsprozess ein, und ein Partner, der mit unvollständigen Anforderungen umzugehen weiß, gestaltet den Projektumfang mit Ihnen gemeinsam.
Planen Sie den Human-in-the-Loop-Prozess
Legen Sie früh fest, was passiert, wenn das Modell unsicher ist oder sich irrt. Vorhersagen mit geringer Konfidenz gehen in eine Prüfwarteschlange, Prüfer korrigieren das Ergebnis mit einem Klick, und diese Korrekturen fließen in den nächsten Trainingslauf ein. Das Monitoring erkennt dann die schleichende Verschlechterung der Genauigkeit, die entsteht, wenn sich Preise, Verhalten und Formate ändern.
Von der Shortlist in die Produktion: ML-Projekte, die sich lohnen
Projekte, die sich auszahlen, sind eng gefasst, sauber gemessen und in die Software integriert, die Ihr Team bereits nutzt. Wählen Sie eine wiederkehrende Entscheidung, prüfen Sie die Daten, legen Sie die Baseline fest und planen Sie den Prüfprozess, bevor jemand Trainingscode schreibt. Diese Reihenfolge macht aus einer Shortlist von Ideen ein System, das sein Budget einspielt und das zweite Projekt finanziert.
Redwerk entwickelt seit 2005 Software, mit über 250 abgeschlossenen Projekten und über 90 Senior-Entwicklern mit Expertise in Python, .NET, Azure und den wichtigsten ML-Frameworks. Wir begleiten Anwendungsfälle von der Discovery-Phase bis zur Produktion und übernehmen ML-Projekte, die nach dem Pilotprojekt ins Stocken geraten sind. Um Ihre Shortlist zu besprechen, kontaktieren Sie uns.
FAQ
Welches sind die häufigsten Machine Learning Anwendungsfälle in Unternehmen?
Am häufigsten sind Nachfrageprognose, Churn-Prognose, Betrugserkennung, Kreditscoring, Datenextraktion aus Dokumenten, Produktempfehlungen, Support-Chatbots und Kandidaten-Matching. Jeder dieser Fälle verbindet eine wiederkehrende Entscheidung mit historischen Ergebnissen und einer klaren Kennzahl.
Welche Branchen profitieren am meisten von Machine Learning?
Finanz- und Versicherungswesen, IT und Software, Einzelhandel, Gesundheitswesen und Fertigung erzielen die besten Ergebnisse. Die Finanzbranche führt bei Betrugs- und Kreditentscheidungen, der Einzelhandel bei Prognosen und Personalisierung, das Gesundheitswesen bei Terminplanung und Dokumententriage und die Fertigung bei der visuellen Inspektion.
Welchen ROI bringt Machine Learning einem mittelständischen Unternehmen?
Der ROI hängt davon ab, wie oft die Entscheidung getroffen wird und welchen Wert jede Verbesserung hat. Ein Churn-Modell, das pro Quartal einige große Kunden hält, oder eine Dokumenten-Pipeline, die täglich Stunden manueller Dateneingabe einspart, zeigt seinen Nutzen in Kennzahlen, die das Unternehmen bereits erfasst.
Wie wählt ein Unternehmen sein erstes Machine-Learning-Projekt aus?
Beginnen Sie mit einer häufigen geschäftlichen Entscheidung, prüfen Sie, ob die Daten in der Form vorliegen, die das Modell in der Produktion sieht, und definieren Sie die Regel oder den manuellen Prozess, den es schlagen muss. Beschränken Sie den Umfang auf ein Team und eine Kennzahl, und planen Sie eine menschliche Prüfung für unsichere Vorhersagen ein.
Was ist der Unterschied zwischen Anwendungsfällen für KI und für Machine Learning?
KI ist das umfassende Fachgebiet, zu dem auch Regel-Engines und große Sprachmodelle gehören. Machine Learning ist der Teilbereich, der aus historischen Daten Muster lernt, um Vorhersagen zu treffen. Prognosen und Scoring sind ML-Anwendungsfälle, während ein Chatbot auf Basis eines gehosteten LLM ein KI-Anwendungsfall ist, der möglicherweise ganz ohne eigenes Training auskommt.
Erfahren Sie, wie Redwerk die Kernentwicklung einer AI-Optimierungsplattform übernahm und bis zum erfolgreichen Produktlaunch führte