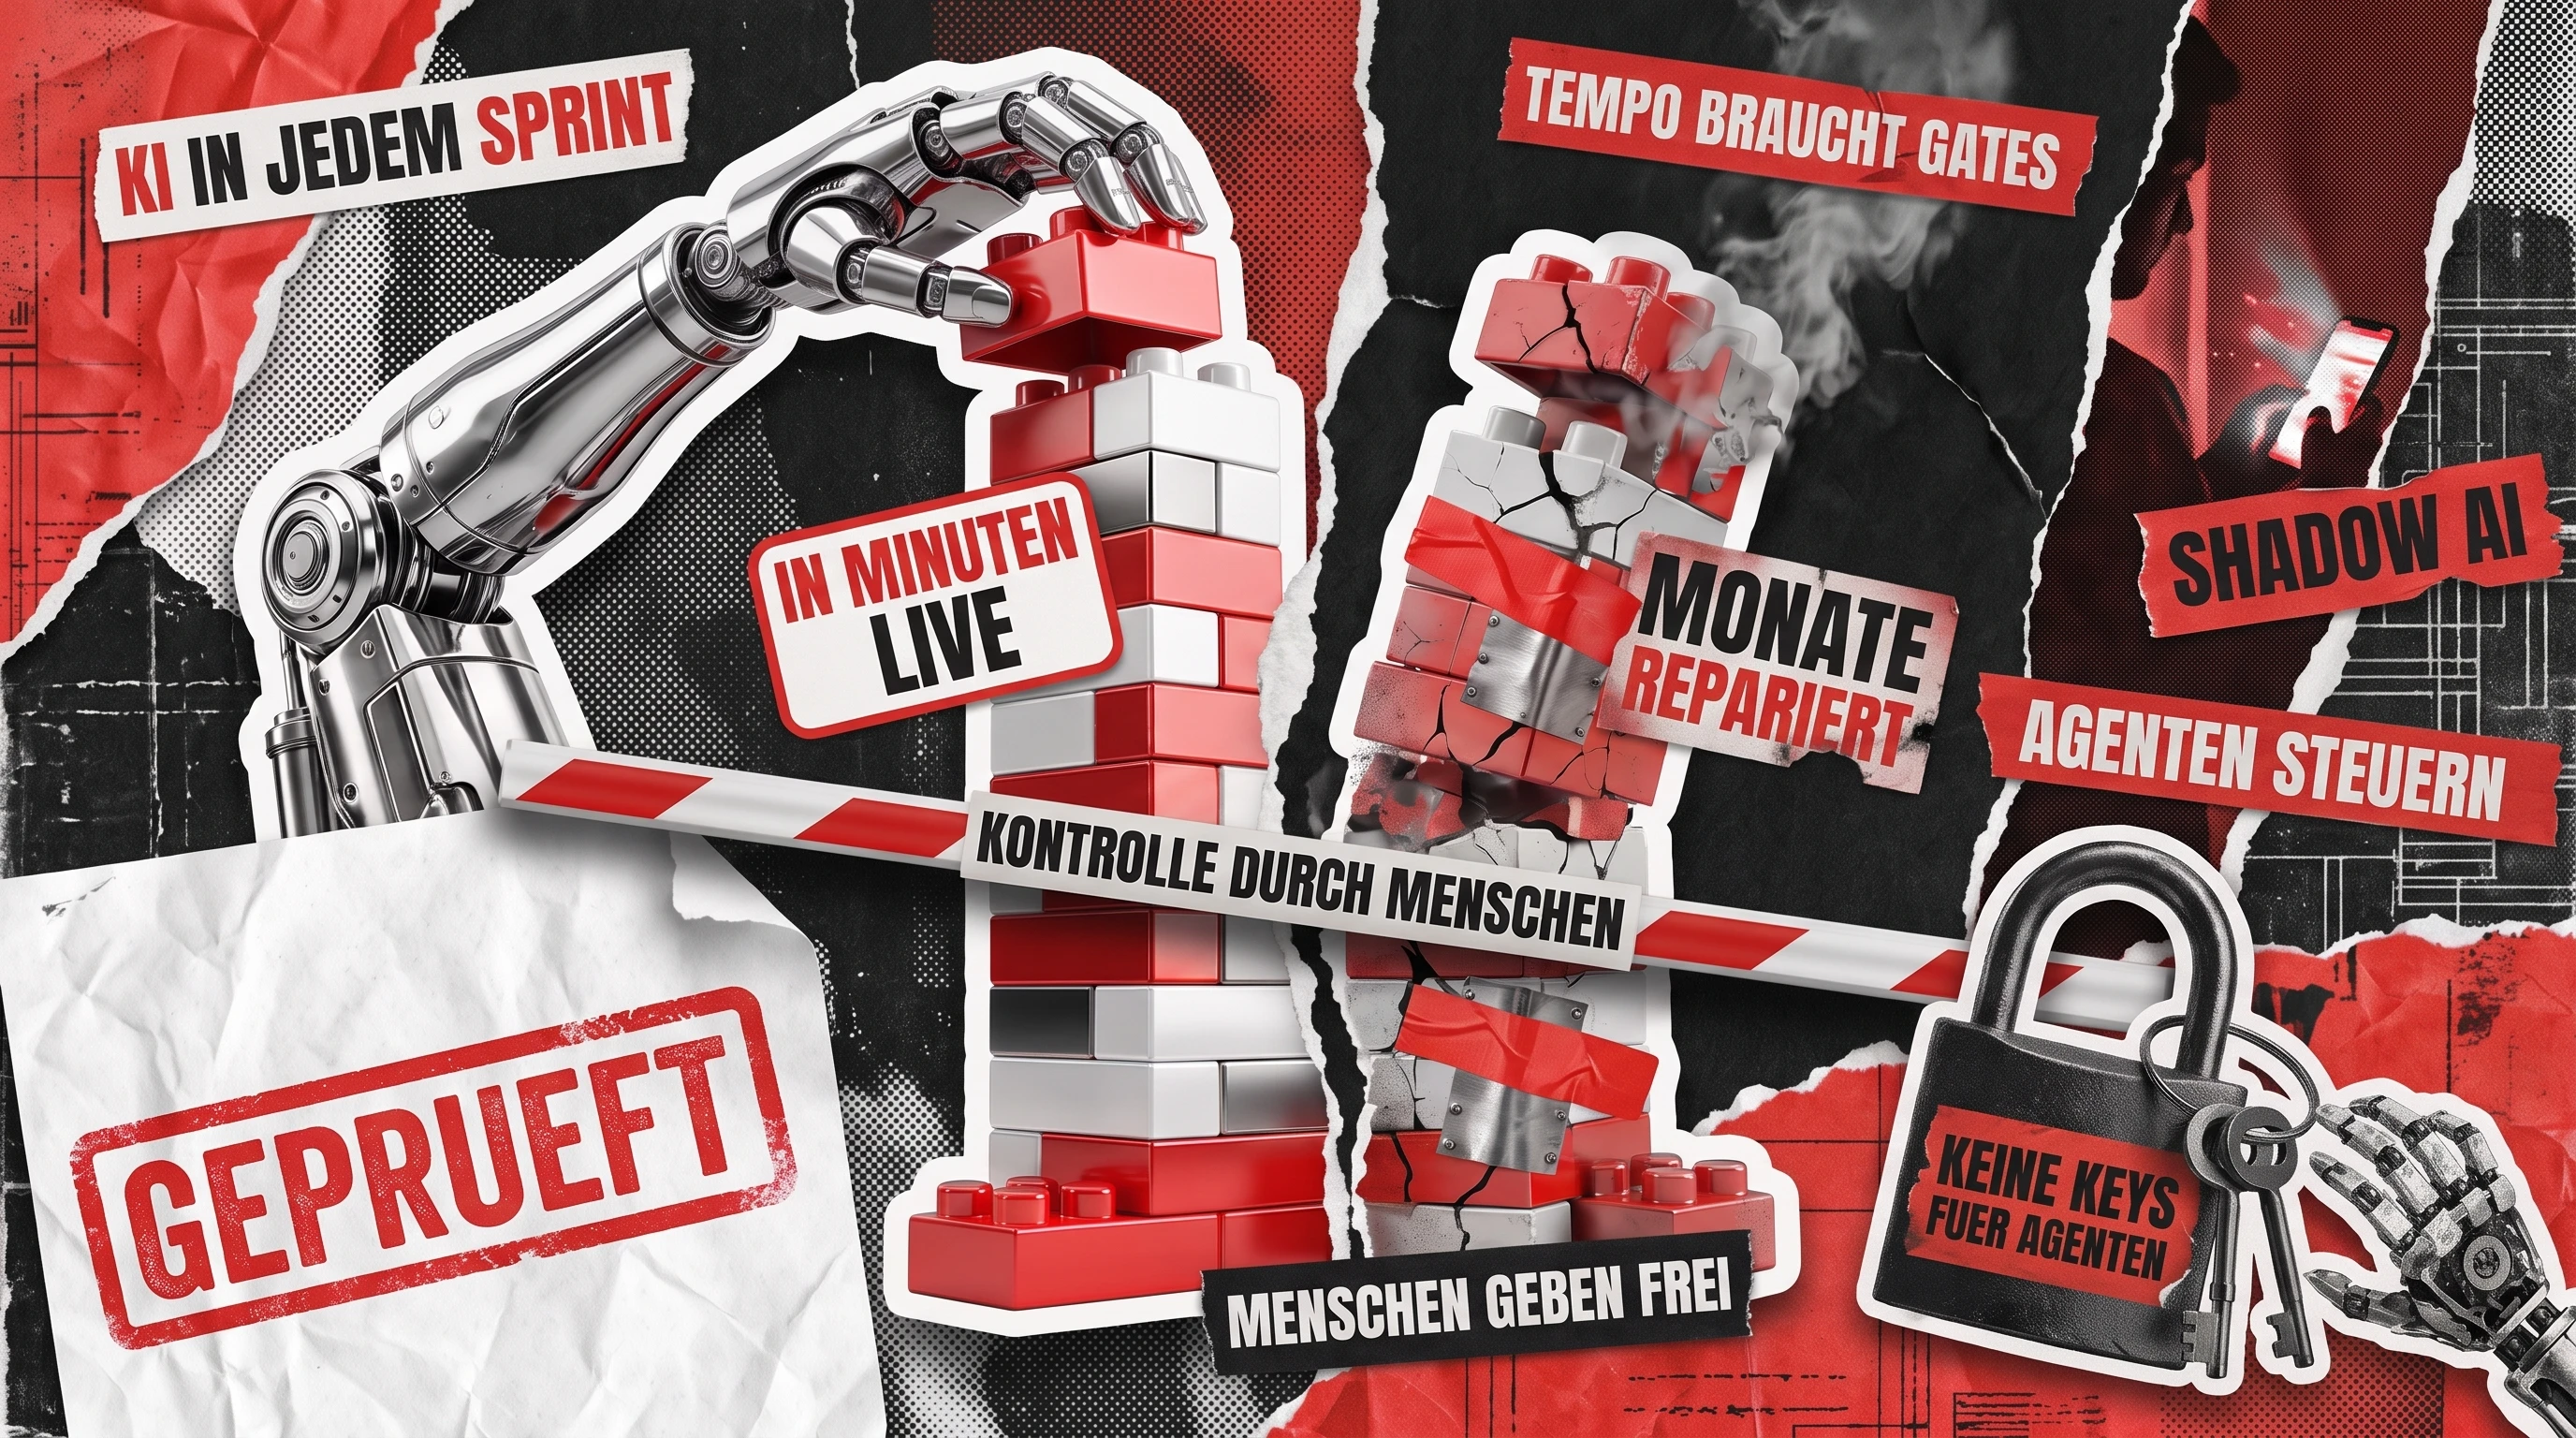
KI in der Softwareentwicklung prägt heute jede Phase der Delivery. Sie entwirft Anforderungen in der Discovery, schreibt und refaktoriert Code, prüft Pull Requests vor, generiert Tests und meldet Schwachstellen in der Wartung. Die Gewinne sind real, aber ungleich verteilt: Am stärksten steigt das Tempo beim Coding und Prototyping, während Review, Sicherheit und Governance darüber entscheiden, ob dieses Tempo den Produktivbetrieb übersteht.
Für Gründer und Engineering Manager wird die Build-Entscheidung damit zu einer Governance-Entscheidung. Welche Phasen bekommen KI, welche Tools sind freigegeben, wer prüft die Ergebnisse, und wie viel Budget fließt ein Jahr später in Aufräumarbeiten? Redwerk liefert seit 2005 Software aus und setzt KI-gestützte Softwareentwicklung in Kundenteams ein. Dieser Leitfaden geht deshalb jede Phase so durch, wie wir sie in echten Projekten handhaben, inklusive der Zielkonflikte.
KI in der Softwareentwicklung: Planung und Discovery
In der Discovery spart KI pro investierter Stunde am meisten Geld, denn jede hier korrigierte Annahme muss später nicht im Code neu geschrieben werden. Statt langer Spezifikationsdokumente entstehen heute strukturierte Anforderungen und klickbare Demos innerhalb weniger Tage. Das Urteil bleibt beim Menschen: Welches Feature bringt Umsatz, welcher Stakeholder hat das letzte Wort, und welches Risiko kann kein Datensatz vorhersagen?
Anforderungen und Aufwandsschätzung
Meeting-Transkripte, Altdokumentation und Support-Tickets lassen sich heute in ein Sprachmodell geben, das daraus User Stories im Entwurf, eine priorisierte Feature-Liste und markierte Widersprüche zwischen Stakeholdern liefert. Die Aufwandsschätzung folgt demselben Muster. Das Modell gleicht den Umfang mit Mustern aus vergleichbaren Projekten ab und liefert eine erste Spanne, die das Team hinterfragen kann. Das ist der Kern dessen, wie KI die Discovery-Phase verändert: schnellere erste Entwürfe, mit menschlicher Validierung als Prüfstein, bevor ein Budget unterschrieben wird.
Schnelleres Prototyping
Die größte Veränderung in der Planung ist der Schritt von statischen Wireframes zu funktionierenden Prototypen schon während der Discovery. Ein klickbarer Build in den ersten Wochen gibt Stakeholdern etwas, worauf sie reagieren können, und diese Reaktionen bringen fehlende Anforderungen früher ans Licht als jedes Dokument. So entstandene Prototypen erfüllen drei Aufgaben:
- Validierung. Nutzer und Investoren testen einen Ablauf, bevor Budget für die Produktion gebunden wird.
- Scope-Kontrolle. Strittige Features werden durch Vorführen geklärt, was die Abnahme verkürzt.
- Architektur-Checks. Der Prototyp legt Integrations- und Datenfragen offen, solange sie noch günstig zu beantworten sind.
Der Haken: Prototyp-Code ist auf Tempo geschrieben. Bevor er zum Fundament des Produkts wird, braucht er einen Neuaufbau oder ein gründliches Review.
Dieser Ansatz passt auch zu Teams, die ohne vollständige Spezifikationen starten, was bei Kunden, die zu Redwerk kommen, häufig der Fall ist. KI macht aus frühen Gesprächen strukturierte Anforderungen und eine funktionierende Demo, und Engineers prüfen die Schätzung anschließend Zeile für Zeile, bevor ein Budget freigegeben wird.
KI-gestütztes Coding
Beim Coding verlief die Einführung am schnellsten, und hier ist der Abstand zwischen Demo und Produktivbetrieb am größten. Die Tools haben sich von der Autovervollständigung im Editor zu Agenten entwickelt, die ein Repository lesen, eine Änderung über mehrere Dateien planen, Tests ausführen und einen Pull Request öffnen. Dadurch verschiebt sich der Arbeitstag eines Senior Engineers hin zum Spezifizieren, Prüfen und Korrigieren, und es ändert sich, was Kunden einen Dienstleister zum Prozess fragen sollten.
Was Coding-Assistenten können
Heutige KI-Coding-Assistenten lassen sich in zwei Gruppen einteilen. Assistenten im Editor vervollständigen und bearbeiten Code, während der Entwickler tippt, Agenten dagegen nehmen eine Aufgabenbeschreibung entgegen und arbeiten selbstständig im gesamten Repository. Beide sind stark bei repetitiver Arbeit und werden schwächer, je mehr eine Aufgabe von Kontext abhängt, der außerhalb des Codes liegt.
Boilerplate, CRUD-Endpunkte, Konfiguration
Gut, mit kleinen Anpassungen
Benennung, Struktur, Teamkonventionen
Refactoring und Framework-Upgrades
Gut bei klar abgegrenzten Modulen
Scope festlegen, Regressionstests
Dateiübergreifende Features per Agent
Gemischt, abhängig von Repo-Qualität und Aufgabenbeschreibung
Aufgaben zerlegen, jeden Diff prüfen
Architektur und Domänenlogik
Schwach
Zielkonflikte, Datenmodell, Geschäftsregeln
Coding-Assistenten nach Einsatzzweck
Der passende Assistent hängt vom Repository, der IDE und den geltenden Sicherheitsregeln ab. Ein toolunabhängiges Setup funktioniert daher besser als ein unternehmensweiter Standard. Diese Optionen decken die meisten Delivery-Szenarien ab:
- Claude Code und OpenAI Codex für agentengesteuerte Aufgaben, auch in Setups mit Anbindung an GitHub, Jira und CI-Pipelines.
- Cursor für Teams mit gemischtem Erfahrungsstand und frontendlastige Arbeit, wo es bei Redwerk-Einsätzen die geringste Einarbeitungshürde hatte.
- GitHub Copilot, Amazon Q Developer (der Nachfolger von CodeWhisperer) und Gemini Code Assist in VS Code und IntelliJ, ausgewählt passend zu Cloud-Anbieter und Repository-Host.
Für proprietäre Codebasen eignen sich Assistenten, die mit Modellen in einer Private Cloud oder On-Premises arbeiten, sodass der Code des Kunden in dessen eigener Umgebung bleibt. Nutzungsdashboards gehören in die erste Woche, denn Kosten pro Lizenz und pro Credit wachsen unbemerkt, sobald ein ganzes Team die Tools nutzt.
Gewinne und Zielkonflikte
Der Produktivitätsgewinn ist im großen Maßstab messbar. Eine Studie aus dem Jahr 2026 mit Zehntausenden Microsoft-Engineers ergab, dass Nutzer von Coding-Agenten für die Kommandozeile rund 24 % mehr Pull Requests mergten, als sie es sonst getan hätten. Kunden unserer KI-gestützten Delivery berichten von bis zu 2x schnellerer Auslieferung in den ersten Sprints.
Der Preis dafür kommt später. Mehr gemergter Code bedeutet mehr Code für das Review, und Assistenten neigen dazu, Logik zu wiederholen, statt sie wiederzuverwenden. Duplikate sind deshalb das erste Problem, das unsere Engineers beim Audit einer stark KI-generierten Codebasis erwarten. Teams, die das Review auslassen, verwandeln ihr Tempo in technische Schulden. Deshalb ist das Aufräumen KI-geschriebener Codebasen inzwischen ein Standardauftrag bei Redwerk.
Code Review und Testing
Review und Testing sind die Phasen, in denen KI-Ergebnisse auf Qualitätsschranken treffen, und sie fangen den Großteil des zusätzlichen Volumens auf, das Coding-Agenten erzeugen. Für beide gibt es heute nützliche Automatisierung, mit Grenzen, die sich in Merge-Raten, fragilen Tests und Bugs zeigen, die jede Prüfung bestehen. Praktisches Ziel ist eine Pipeline, in der Maschinen den ersten Durchgang übernehmen und Engineers die finale Entscheidung treffen.
KI im Code Review
KI-Reviewer wie SonarQube und DeepCode AI kommentieren einen Pull Request innerhalb von Minuten und finden Stilprobleme, typische Fehlermuster, fehlende Null-Checks und bekannte Schwachstellensignaturen. Dieser erste Durchgang verschafft Senior-Reviewern Zeit für Design, Datenfluss und Geschäftsregeln. Vollautomatisches Review ist eine andere Geschichte. Eine Studie aus dem Jahr 2026 mit 3.109 Pull Requests ergab, dass PRs, die nur von Code-Review-Agenten geprüft wurden, eine Merge-Rate von 45,20 % erreichten, gegenüber 68,37 % bei von Menschen geprüften PRs, bei deutlich höherer Abbruchquote.
Am stärksten ist ein Setup, das KI-gestützte Code Reviews für den ersten Durchgang mit einem Senior Engineer für die Freigabe kombiniert. So eingesetzt, berichten Kunden unserer KI-gestützten Delivery von bis zu 60 % weniger Zeitaufwand für Code Reviews.
Grenzen der Testgenerierung
KI-Testgenerierung glänzt bei der Menge. Sie entwirft Unit-Tests für bestehende Funktionen, schließt Abdeckungslücken und erzeugt Grenzfall-Eingaben schneller als jeder Engineer. An vier Stellen tut sie sich schwer:
- Tests, die den Code spiegeln. Aus der Implementierung generiert, bestätigen sie, was der Code tut, Bugs eingeschlossen.
- Coverage-Theater. Der Abdeckungsgrad steigt, während kritische Geschäftsabläufe ungetestet bleiben.
- Fragile End-to-End-Suites. Generierte UI-Tests brechen bei kleinen Layoutänderungen und erzeugen zusätzlichen Wartungsaufwand.
- Fehlende Absicht. Das Modell kennt nur die Akzeptanzkriterien, die jemand aufgeschrieben hat.
Wir behandeln generierte Tests als Entwürfe. Ein QA Engineer prüft jeden einzelnen gegen die Anforderungen, bevor er in die Suite aufgenommen wird.

Wartung und Sicherheit
Der Großteil der Produktkosten fällt nach dem Launch an, daher summieren sich KI-Einsparungen vor allem in der Wartung. Dieselben Tools, die die Auslieferung beschleunigen, vergrößern aber auch die Angriffsfläche, denn jeder Assistent, jedes Plugin und jeder Agent wird Teil der Software-Lieferkette. Deshalb gehören beide Themen in ein Gespräch: Jeder Gewinn auf der einen Seite schafft eine neue Pflicht auf der anderen.
Weniger Wartungsaufwand
KI übernimmt heute einen Großteil der Routinepflege: Dependency-Upgrades, Log-Analyse, Bug-Triage und Dokumentation für Code, an dessen Entstehung sich niemand mehr erinnert. Die Indexierung der Codebasis ist der unterschätzte Gewinn. Neue Engineers können ein Repository direkt befragen, statt auf einen Senior-Kollegen zu warten. Das ist ein Grund, warum wir uns innerhalb von Tagen in ein übernommenes Produkt einarbeiten können. So zeigt sich, wie KI-gestützte Softwarewartung Unternehmen verändert, die Produkte über Jahre betreiben: Routinepflege wird günstiger, und die Zeit der Senior Engineers fließt in Ursachenanalysen von Incidents, Release-Entscheidungen und regulierte Daten.
Neue Sicherheitsrisiken
Angreifer nutzen dieselben Tools. Die IBM-Studie Cost of a Data Breach 2026 ergab, dass jede vierte böswillige Sicherheitsverletzung KI-gestützt war, ein Anstieg um 56 % gegenüber dem Vorjahr, und mehr als 20 % der Organisationen meldeten einen Vorfall, der auf KI-Modelle oder KI-Anwendungen zielte. Innerhalb der Codebasis prüfen wir am häufigsten auf diese Risiken:
- Unsichere Vorschläge: Injection-Schwachstellen, schwache Eingabevalidierung und hartcodierte Secrets, die im Review korrekt aussehen.
- Halluzinierte Pakete: Importe erfundener Abhängigkeiten, die Angreifer später unter demselben Namen registrieren.
- Prompt-Leaks: API-Schlüssel und Kundendaten, die in Chat-Tools eingefügt werden.
- Agenten mit zu vielen Rechten: Schreibzugriff auf Repositories, CI oder Produktion, der aus Bequemlichkeit vergeben wurde.
Jede KI-generierte Änderung in unseren Projekten durchläuft dieselben OWASP-konformen Prüfungen wie von Menschen geschriebener Code. Die ehrliche Antwort auf die Frage, ob KI-gestützte Entwicklung sicher ist, hängt genau davon ab, dass diese Kontrollen greifen, bevor Agenten im ganzen Team skaliert werden.
Schatten-KI und Governance
Governance ist die Phase, die die meisten Teams zuletzt ergänzen und zuerst brauchen. Entwickler übernehmen jede Woche neue Tools, und jeder nicht freigegebene Assistent ist eine Stelle, an der Code, Zugangsdaten oder Kundendaten das Unternehmen verlassen können. Die Aufsicht muss den gesamten KI-gestützten Softwareentwicklungszyklus abdecken, vom Prompt, den ein Product Manager in der Discovery eintippt, bis zum Agenten, der über Nacht einen Pull Request öffnet.
Typische Formen von Schatten-KI
Schatten-KI (Shadow AI) bezeichnet den Einsatz von KI-Tools ohne Freigabe oder Überwachung durch die Engineering- oder Security-Leitung. In Softwareteams wirkt sie ganz alltäglich: ein Assistent im Privattarif, bezahlt mit der eigenen Karte eines Entwicklers, ein Browser-Chatbot zum Debuggen eines Stack Traces aus der Produktion, ein lokaler Agent mit Verbindung zu einer internen Datenbank oder eine SaaS-Funktion, die per Update KI-Verarbeitung aktiviert hat. Jeder dieser Fälle schafft ein Risiko, das niemand verfolgt, von lizenziertem Code, der in ein proprietäres Repository kopiert wird, bis zu Secrets, die auf den Servern eines Drittanbieters liegen. Die Erkennung von Schatten-KI im SDLC beginnt bei Netzwerkverkehr, SaaS-Logs und Signalen aus dem Repository, denn schriftliche Richtlinien allein übersehen den Großteil der tatsächlichen Aktivität.
Praxistaugliche Kontrollstruktur
Governance funktioniert, wenn der freigegebene Weg der einfachste ist. Diese sechsteilige Kontrollstruktur richten wir in den ersten Wochen einer Zusammenarbeit ein:
- Eine Liste freigegebener Tools mit Enterprise-Konten, damit die offizielle Option so einfach nutzbar ist wie eine private.
- Private Modell-Endpunkte oder Endpunkte ohne Datenspeicherung (Zero Retention) für jedes Repository mit proprietärem oder reguliertem Code.
- Pull-Request-Labels oder Commit-Trailer, die KI-generierte Änderungen kennzeichnen, damit Reviews und Audits nachvollziehbar bleiben.
- Menschliches Review und automatisiertes Security-Scanning bei jeder von KI verfassten Änderung, auch bei kleinen Diffs.
- Eng begrenzte Agentenrechte: standardmäßig Lesezugriff, Schreibzugriff pro Aufgabe, und Produktionszugangsdaten bleiben außer Reichweite.
- Dashboards für Nutzung und Kosten mit monatlicher Prüfung, dazu eine einseitige Richtlinie, welche Daten in welches Tool dürfen.
Jede Kontrolle ist in wenigen Tagen eingerichtet. Zusammen machen sie die KI-Nutzung für das eigene Team des Kunden sichtbar und auditierbar.
Governance als Wettbewerbsvorteil
Die letzten zwei Jahre haben die Adoptionsfrage für die meisten Engineering-Teams beantwortet: Die Tools zu besitzen, ist heute die Grundlage. Offen ist die Frage der Kontrolle: Welche Phasen sind automatisiert, welche abgesichert, und wie schnell werden Probleme in KI-Ergebnissen erkannt? Ein Jahr später kann ein Team mit denselben Assistenten eine saubere, erweiterbare Codebasis haben und ein anderes eine, die durch Review-Schulden und Nacharbeit ausgebremst wird. Den Unterschied macht der Prozess.
Redwerk liefert seit 2005 Software aus und hat 30+ KI-gestützte Projekte umgesetzt, mit Claude Code, Codex, Cursor und Copilot im Einsatz in Kundenteams. Wir bringen Tooling, Review-Disziplin und Governance-Setup als ein Paket mit und halten Kunden bei jedem Schritt auf dem Laufenden. Diese Kombination passt zu Teams ohne vollständige Spezifikationen, zu Teams mit internen Kompetenzlücken und zu Teams, die eine KI-geschriebene Codebasis übernehmen, die gerettet werden muss. Wenn Sie KI-Tempo mit produktionsreifer Kontrolle verbinden möchten, kontaktieren Sie uns, und wir zeigen Ihnen, wo KI in Ihr Produkt passt.
FAQ
Welche SDLC-Phasen profitieren am meisten?
Coding und Discovery zeigen die schnellsten Gewinne, weil KI Code, Anforderungen und Prototypen in einem Bruchteil der üblichen Zeit entwirft. Code Review und Wartung folgen, wobei KI den ersten Durchgang und die Routinepflege übernimmt. Architektur, Sicherheitsfreigabe und Release-Entscheidungen profitieren am wenigsten und bleiben bei Senior Engineers.
Ist KI-generierter Code produktionssicher?
Das kann er sein, sobald er dieselben Prüfschritte durchläuft wie von Menschen geschriebener Code: Peer Review, automatisiertes Security-Scanning und Tests auf Basis echter Anforderungen. Ungeprüfter KI-Output enthält oft duplizierte Logik, schwache Eingabevalidierung oder erfundene Abhängigkeiten. Sicherheit entsteht daher durch den Prozess rund um das Tool.
Wie sollte ein Entwicklungspartner KI einsetzen?
Ein verlässlicher Partner setzt KI in Discovery, Coding, Code Review, Testing und Wartung ein und behält in jeder Phase einen menschlichen Kontrollpunkt. Bei Redwerk bedeutet das Tools wie Claude Code, OpenAI Codex, Cursor und GitHub Copilot, wobei jede von KI verfasste Änderung ein menschliches Review und Sicherheitsprüfungen durchläuft. Proprietärer Code läuft auf privaten oder On-Premises-Modellen, wenn der Kunde dies verlangt.
Sehen Sie, wie wir ein Legacy-Produkt in eine AI-gestützte Growth-Plattform verwandelt haben: der Evolv-Build, über 20 Produktiv-Releases mit einem 9-köpfigen Team